Wrapper vs Inner Performance
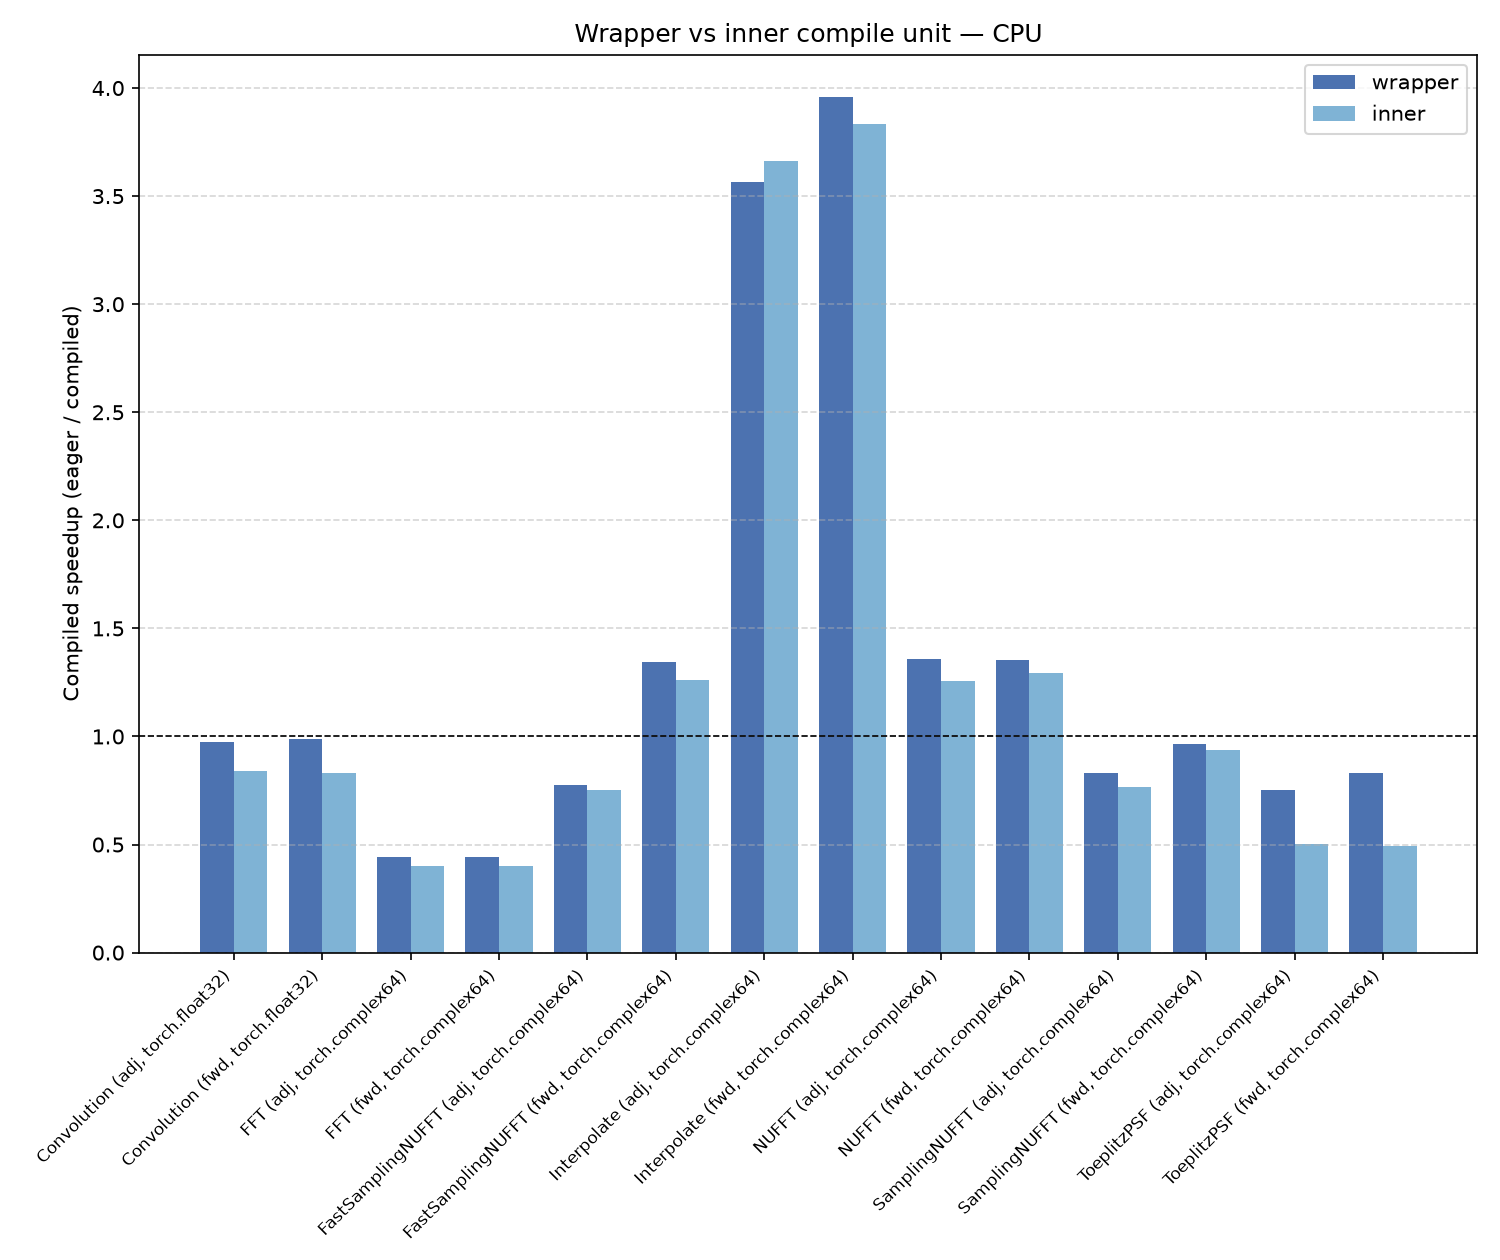
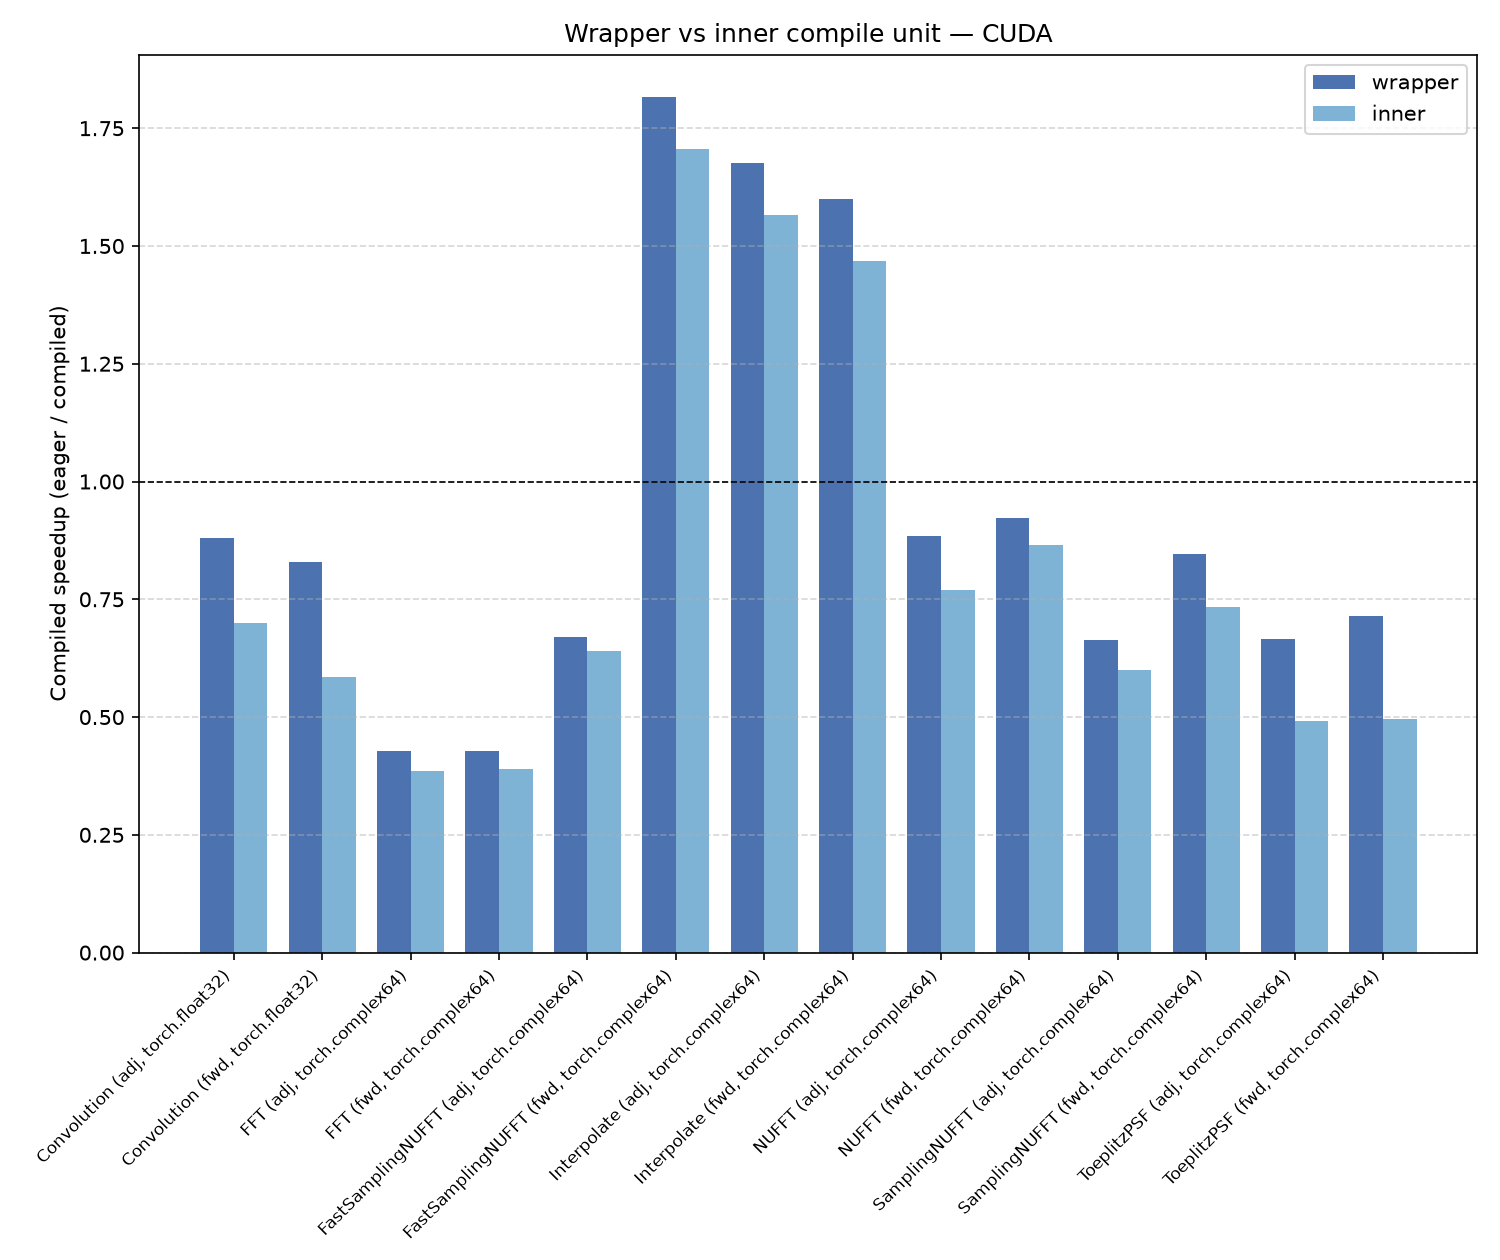
The wrapper level compiles the NamedLinop call path, including shape checks and context bookkeeping. The inner level compiles the bare fn/adj_fn/normal_fn.
Wrapper vs inner by operator
| Operator | Device | Wrapper median | Inner median |
|---|---|---|---|
| Add | cpu | 5.48x | — |
| Add | cuda | 2.52x | — |
| ArrayToBlocks | cpu | 2.87x | — |
| ArrayToBlocks | cuda | 2.12x | — |
| BlocksToArray | cpu | 2.63x | — |
| BlocksToArray | cuda | 2.00x | — |
| Chain | cpu | 4.73x | — |
| Chain | cuda | 2.35x | — |
| Concat | cpu | 0.95x | — |
| Concat | cuda | 0.95x | — |
| Convolution | cpu | 0.98x | 0.84x |
| Convolution | cuda | 0.85x | 0.64x |
| Dense | cpu | 1.65x | — |
| Dense | cuda | 1.34x | — |
| DenseSimple | cpu | 1.63x | — |
| DenseSimple | cuda | 1.38x | — |
| Diagonal | cpu | 0.82x | — |
| Diagonal | cuda | 0.74x | — |
| FFT | cpu | 0.44x | 0.40x |
| FFT | cuda | 0.43x | 0.39x |
| FastSamplingNUFFT | cpu | 1.06x | 1.01x |
| FastSamplingNUFFT | cuda | 1.24x | 1.17x |
| Identity | cpu | 0.70x | — |
| Identity | cuda | 0.67x | — |
| Interpolate | cpu | 3.76x | 3.75x |
| Interpolate | cuda | 1.64x | 1.52x |
| NUFFT | cpu | 1.36x | 1.27x |
| NUFFT | cuda | 0.90x | 0.82x |
| Pad | cpu | 0.93x | — |
| Pad | cuda | 0.80x | — |
| PadDim | cpu | 0.82x | — |
| PadDim | cuda | 0.80x | — |
| Rearrange | cpu | 0.81x | — |
| Rearrange | cuda | 0.70x | — |
| Repeat | cpu | 1.09x | — |
| Repeat | cuda | 0.91x | — |
| Sampling | cpu | 1.99x | — |
| Sampling | cuda | 2.07x | — |
| SamplingNUFFT | cpu | 0.90x | 0.85x |
| SamplingNUFFT | cuda | 0.75x | 0.67x |
| Scalar | cpu | 0.82x | — |
| Scalar | cuda | 0.69x | — |
| ShapeSpec | cpu | 0.69x | — |
| ShapeSpec | cuda | 0.69x | — |
| SimpleLinop | cpu | 1.02x | — |
| SimpleLinop | cuda | 0.85x | — |
| Stack | cpu | 0.89x | — |
| Stack | cuda | 0.91x | — |
| SumReduce | cpu | 1.11x | — |
| SumReduce | cuda | 0.94x | — |
| ToDevice | cpu | 1.11x | — |
| ToDevice | cuda | 0.95x | — |
| ToeplitzPSF | cpu | 0.79x | 0.50x |
| ToeplitzPSF | cuda | 0.69x | 0.49x |
| Truncate | cpu | 0.85x | — |
| Truncate | cuda | 0.79x | — |
| Zero | cpu | 0.81x | — |
| Zero | cuda | 0.68x | — |
| functional.fold | cpu | — | 1.29x |
| functional.fold | cuda | — | 1.13x |
| functional.grid | cpu | — | 2.37x |
| functional.grid | cuda | — | 0.83x |
| functional.unfold | cpu | — | 1.18x |
| functional.unfold | cuda | — | 1.25x |
| functional.ungrid | cpu | — | 2.57x |
| functional.ungrid | cuda | — | 0.84x |
Graph-break details
- Concat (wrapper, adj, cuda, default) — 1 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/namedlinop.py:151 in forward: Unsupported method call- Concat (wrapper, fwd, cpu, default) — 0 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/concat.py:173 in _fn: generic_jump TensorVariable()- Concat (wrapper, fwd, cuda, default) — 1 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/namedlinop.py:151 in forward: Data-dependent branching/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/concat.py:173 in _fn: generic_jump TensorVariable()- FastSamplingNUFFT (wrapper, adj, cpu, default) — 3 breaks
- FastSamplingNUFFT (inner, adj, cpu, default) — 3 breaks
- FastSamplingNUFFT (wrapper, adj, cuda, default) — 4 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/namedlinop.py:151 in forward: Data-dependent branching- FastSamplingNUFFT (inner, adj, cuda, default) — 3 breaks
- SamplingNUFFT (wrapper, adj, cpu, default) — 1 breaks
- SamplingNUFFT (inner, adj, cpu, default) — 1 breaks
- SamplingNUFFT (wrapper, adj, cuda, default) — 2 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/namedlinop.py:151 in forward: Data-dependent branching- SamplingNUFFT (inner, adj, cuda, default) — 1 breaks
- Stack (wrapper, adj, cpu, default) — 0 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/stack.py:213 in _fn: Unsupported method call- Stack (wrapper, adj, cuda, default) — 1 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/namedlinop.py:151 in forward: Unsupported method call/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/stack.py:213 in _fn: Unsupported method call- Stack (wrapper, fwd, cuda, default) — 1 breaks
/home/mark/.local/share/opencode/worktree/d3d230/compiled-benchmarks/src/torchlinops/linops/namedlinop.py:151 in forward: Unsupported method call
Functional Kernels
| Operator | Device | Dtype | Config | Class | Graph breaks | Speedup | Details |
|---|---|---|---|---|---|---|---|
| functional.fold | cpu | torch.complex64 | default | works | 0 | 1.29x | details |
| functional.fold | cuda | torch.complex64 | default | works | 0 | 1.13x | details |
| functional.grid | cpu | torch.complex64 | default | works | 0 | 2.37x | details |
| functional.grid | cuda | torch.complex64 | default | compiles_slower | 0 | 0.83x | details |
| functional.unfold | cpu | torch.complex64 | default | works | 0 | 1.18x | details |
| functional.unfold | cuda | torch.complex64 | default | works | 0 | 1.25x | details |
| functional.ungrid | cpu | torch.complex64 | default | works | 0 | 2.57x | details |
| functional.ungrid | cuda | torch.complex64 | default | compiles_slower | 0 | 0.84x | details |
Charts
CPU
GPU
See Methodology for timing, graph-break, and level definitions.